합성데이터 생성 방법에 대한 이해
합성데이터는 실제 데이터의 통계적 패턴을 보존하면서 개인 식별이 되지 않도록 만든 인공 데이터입니다. 요즘 AI 개발을 하려고 할때, 학습용 데이터가 필요하게 되는데 실제 데이터의 통계적 패턴이 필요하므로 합성데이터를 활용하여 AI 학습을 진행하게 됩니다. 수집 가능한 데이터는 얼마 되지 않지만, 많은 데이터의 학습을 통해 좀 더 정확한 모델을 개발하고자 할때 기존 데이터를 이용하여 합성데이터를 만들수 있게 됩니다. 합성데이터가 가명정보인가 익명정보인가 하는 논란은 아직도 있지만, 외부 공개를 해도 개인 식별이 되지 않은 데이터 특성이 있기 때문에 익명정보로 보는것이 타당합니다. 그러나, 원본으로부터 만들어졌다는 점에서 재식별 위험이 0은 아닙니다. 항상 위험평가를 통해 점검해야 하는 절차가 필요합니다.
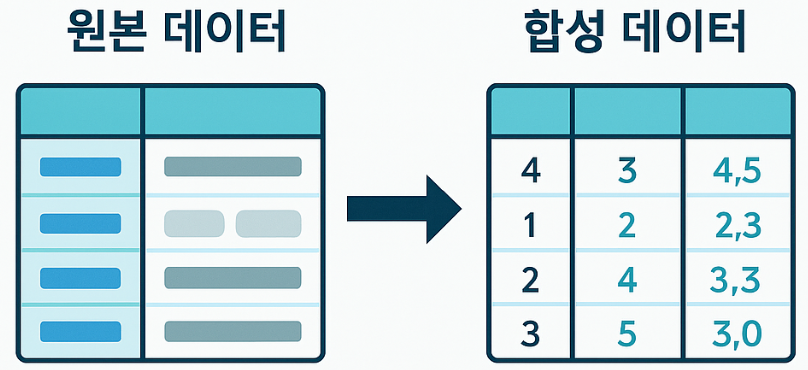
개인정보보호법과 가명정보 처리 가이드라인을 기준으로 보면 원본이 개인(식별)정보라면 합성 과정 자체가 처리에 해당되어 안전조치와 기록관리가 필요하게 됩니다. 결과물이 개인 정보로 볼 수 없을 정도(재식별 불가능) 라면 "익명정보"로 간주 가능하지만, 이는 사후 위험 평가로 입증해야 합니다.
합성데이터를 생성하는 방법에는 규칙 샘플링 기반으로 난수/규칙 기반 생성, 통계 분포 기반 생성, 부트스트랩/재표본 방식이 있습니다. 데이터 증강, 생성 모델 기반으로는 GAN/VAE/Diffusion과 LLM기반 표형/텍스트 합성 방법등 다양한 생성방법이 있습니다.
합성데이터를 생성하기 위해서는 1. 목적 정의를 하고, 2. 스키마/제약사항을 수립, 3. 민감도 분류와 법적근거를 확인, 4. 생성 방법을 선택, 5. 품질(유용성) 평가, 6. 프라이버시(위험) 평가, 7. 문서화/기록관리 순으로 진행하게 됩니다.
여러가지 도구와 라이브러리를 이용하면 합성데이터를 생성할 수 있습니다. 파이썬의 경우 Faker, NumPy/Scipy, pandas, SDV, ydata-synthetic과 같은 라이브러리가 있으며 상용 프로그램으로는 Gretel, Mostly AI, Synthesized등 다양한 도구와 라이브러가 합성데이터 생성을 지원하고 있습니다.
합성데이터를 생성할 때 원본을 복붙하는 형태로 합성하는 경우는 재식별 위험이 높습니다. 이경우 노이즈를 추가하거나 분포 기반으로 전환하는것이 필요합니다. 상관관계를 무시하는 생성하는 경우에는 규칙만으로 생성하므로 모델 성능이 별로 좋지 않습니다. 공동 분포나 조건부 생성 방식을 도입하여야 합니다. 또한, 합성데이터는 가짜데이터이므로 안전하다고 판단하는것은 잘못된것입니다. 품질과 위험 지표에 대해서 점검을 해야 합니다. 그리고, 기록 작성을 하지 않는 경우도 문제가 됩니다. 누가 어떤 목적으로 만들었는지에 대한 합성데이터 생성에 대한 처리기록을 보관하여야 합니다.
합성데이터는 "데이터를 마음껏 쓰고 싶은 팀"과 "프라이버시를 지켜야 하는 조직" 사이의 현실적인 타협점입니다. 하지만, 유용성 평가와 재식별 위험 평가를 함께 운영해야 진짜 안전하고 쓸모 있는 합성데이터가 만들어집니다.
이 글은 필자의 네이버 블로그에도 게시되었습니다.