가명처리 수준과 데이터 활용성의 트레이드오프: 보호냐 활용이냐, 그것이 문제다.
인공지능 (AI) 와 데이터 산업이 폭발적으로 성장하면서 가명정보는 더 이상 선택이 아닌 필수가 되었습니다. 하지만, 여기엔 언제나 딜레마가 따릅니다. 개인정보를 보호할수록 데이터는 쓸모가 없어지고, 반대로 활용도를 높이면 개인정보 보호 수준은 낮아질 수 있다는 것입니다. 가명처리 수준과 데이터 활용성 간의 트레이드 오프(trade-off) 관계를 알아보도록 하겠습니다.
가명처리는 개인정보보호법 제2조제1호의2에 정의된 개념으로, 특정 개인을 직접 식별할 수 없도록 처리하는 방법입니다. 예를들어, 이름이나 주민등록번호를 삭제하거나 대체하는 등 변환하는것을 말합니다.
가명정보는 추가정보 없이는 특정 개인을 식별할 수 없지만,
과학적 연구나 통계작성 목적등에서는 유용하게 활용될 수 있습니다.
가명처리 수준은 얼마나 강하게 개인을 식별할 수 있는 요소를 제거하거나 대체하는것을 말합니다. 이것은 다음과 같은 기준으로 판단합니다.
식별 가능성 감소 수준
다른 데이터와의 결합 가능성
추가정보 분리보관 여부 및 관리적 조치의 엄격함
가명처리 수준이 낮으면 데이터 활용성은 높아집니다. 예를들어 이름만 제거하고 주소, 연령, 소득정보를 유지한다면 데이터 활용성이 높겠지요. 그리고, 일부 데이터를 범주화하여 가명처리 수준을 보통 수준으로 하면 데이터의 활용성도 중간단계로 됩니다. 그런데, 민감정보 제거, 난수화처리, 암호화 등 가명처리 수준을 매우 높게 적용하면 데이터의 활용성은 낮아지게 됩니다.
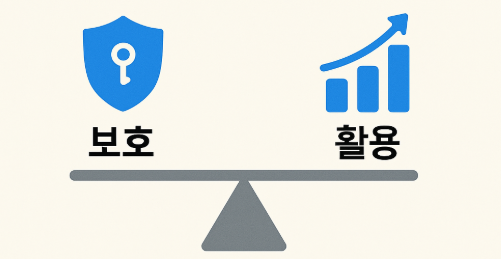
보호를 강화하는 경우 분석 정밀도가 떨어지고, 데이터 결합도 어려워져 AI 학습, 정책 마련, 연구 정확성이 낮아지게 됩니다.
활용성을 우선시 하여 처리하는 경우 개인정보의 재식별 위험도가 증가하게 되어 개인정보 침해 가능성이 높아지게 됩니다.
가명처리는 가명처리 수준과 활용성을 고려한 균형이 중요
정부와 기업, 연구기관은 개인정보가 충분히 보호되면서도 실용적인 데이터를 확보해야 하는 과제에 직면해 있습니다. 이때 핵심은 식별위험성 평가를 통해 위험을 관리하면서도 목적 달성을 위한 적합한 최소한의 가명처리 수준을 적용하는 것입니다.
이를 해결하기 위해서는 위험 기반 접근(Risk-based Approach)와 식별 가능성 평가 도구를 활용하고 추가정보 분리 보관 원칙을 철저히 준수하는것입니다.
이것들은 가명처리 과정에서 가장 중요합니다. 가명처리는 보통 짧게는 3개월 길면 1년이 걸릴수도 있습니다. 상당한 시간과 노력이 들어가야 하는 가명처리 작업입니다. 이러한 과정에서는 가명처리 전문 기업을 통해 배경지식과 경험을 바탕으로 시간을 단축하고 효과적인 결과를 얻는데 도움이 될것입니다.
가명처리 수준과 데이터 활용성 간에는 피할수 없는 갈등 관계가 있습니다. 하지만, 중요한 것은 무조건 높은 수준의 가명처리가 능사는 아니라는 것입니다. 보호는 충분히, 활용은 최대한 이라는 원칙 아래에 목적에 맞는 설계와 적정성 검토를 통해 데이터 딜레마를 현명하게 해결할 수 있습니다.
이 글은 필자의 네이버 블로그에도 게시되었습니다.