비식별정보, 정말 안전할까 ? - 재식별 공격 사례(해외)로 본 교훈
최근 공공기관과 민간기업은 개인정보 보호를 위하여 데이터를 가명처리하거나 비식별화하여 활용하고 있습니다. 하지만 "비식별정보"라고 해서 무조건 안전하다고 볼 수 없습니다. 왜냐하면 외부 데이터와 결합하거나 분석 기술이 고도화되면 다시 특정 개인을 식별할 수 있기 때문입니다. 이것을 재식별이라고 합니다.
대표적인 재식별 공격 사례
1. 넷플릭스 영화 평점 사건
2006년 넷플릭스는 영화 추천 알고리즘 개선을 위해 50만명의 영화 평점 데이터를 비식별처리하여 공개하였습니다. 이름 등 직접 식별자는 제거하였지만, 연구자들은 영화 DB 사이트의 일부 평점과 결합하여 사용자를 식별할 수 있었습니다.
=> 공개된 데이터가 다른 데이터와 결합되면 쉽게 재식별 될 수 있습니다.
2. 미국 병원 진료 데이터 유출
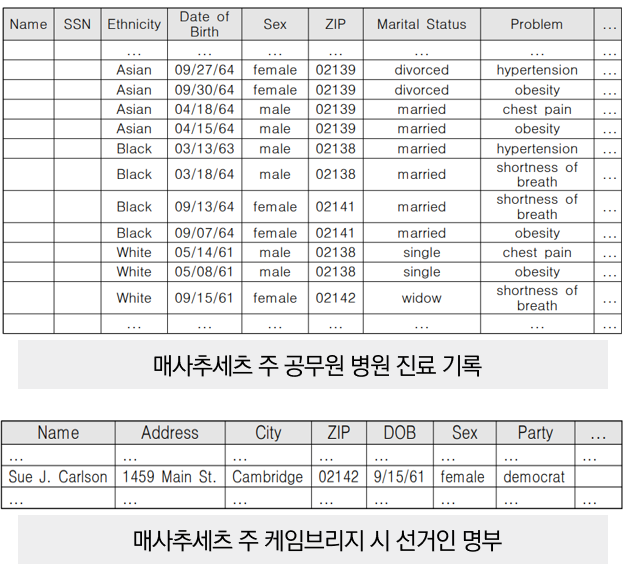
1997년 미국 매사추세츠주의 한 병원은 환자 진료 기록에서 이름, 주소 등을 삭제한 뒤 연구 목적으로 공개하였습니다. 하지만, 해당 데이터와 유권자 등록
명부를 비교하자 일부 환자의 신원을 식별할 수 있었습니다.
=> 비식별화의 핵심은 결합 위험을 최소화하는 것입니다.
3. 위치 데이터 재식별
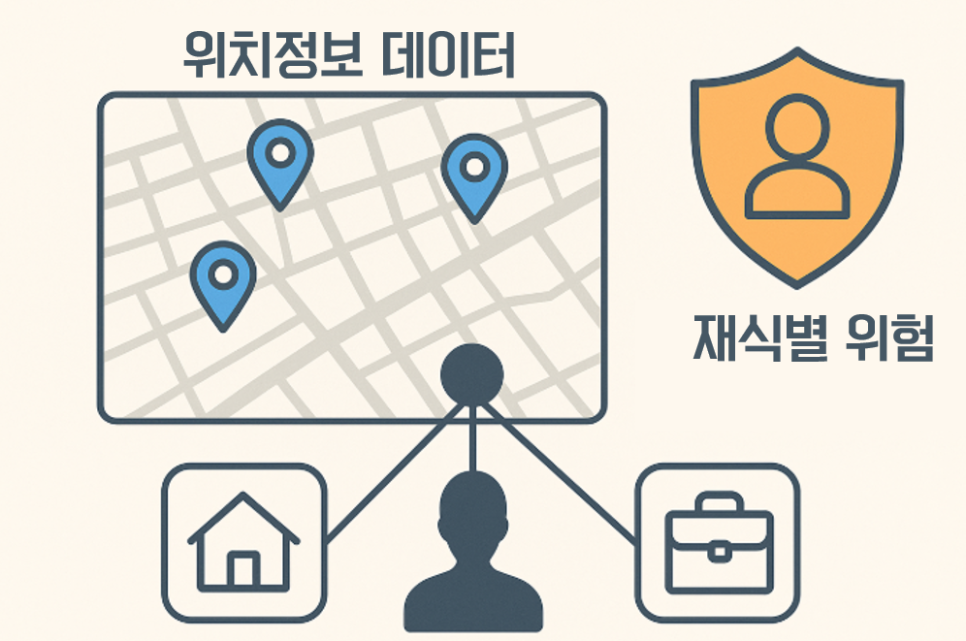
스마트폰 위치 데이터를 수집하여 개인 식별자를 제거하더라도 이동 패턴만으로 개인을 추적할 수 있습니다.
MIT연구진은 단 4개의 위치 정보만으로 95% 이상 사용자를 식별할수 있었습니다.
=> 위치정보는 매우 강력한 식별자 역할을 할 수 있습니다.
4. AOL 검색 기록 유출 사건
2006년 미국의 인터넷 기업 AOL은 연구 목적으로 65만명 사용자의 검색어 기록 2000만건을 비식별화 처리해서 외부 연구자들에게 공개하였습니다. 사용자 계정(ID) 대신 임의의 숫자를 대체하였고, 이름 등 직접 식별자는 제거하였습니다. 그런데 검색어 자체에 개인을 식별할 수 있는 단서가 포함되어 있어 문제가 발생하였습니다.
=> 텍스트 비정형 데이터는 재식별 가능성을 철저히 검토하여야 합니다.
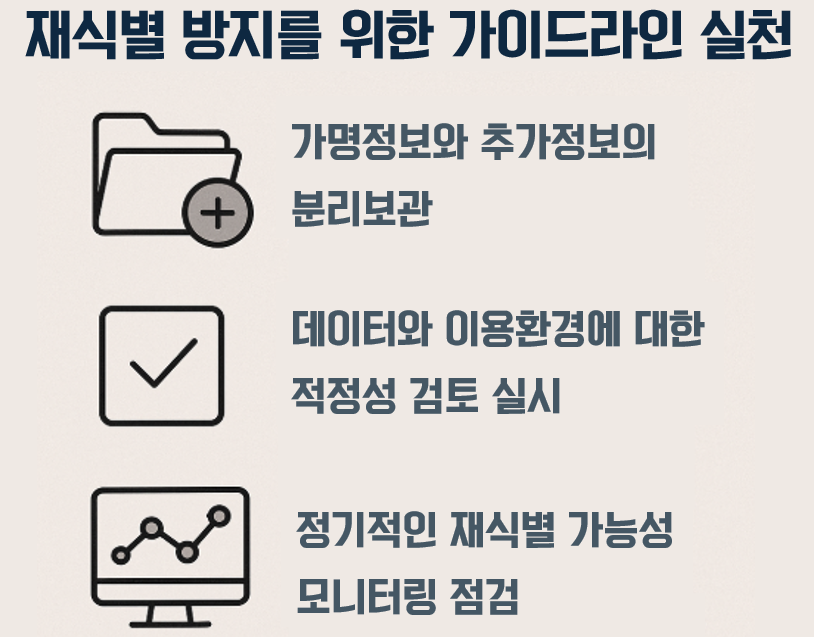
재식별 방지를 위한 가이드라인 실천
추가정보 분리보관
- 가명정보는 추가정보와 분리하여 보관해야 하며, 접근권한을 분리하여 관리하여야 합니다.
적정성 검토 실시
- 데이터와 이용환경에 따른 재식별 위험을 사전에 평가하고 안전성을 확보해야 합니다.
정기적인 모니터링
- 비식별정보라고 하더라도 데이터 활용 주기마다 재식별 가능성을 점검하여야 합니다.
데이터 활용은 중요합니다. 보호조치가 없다면 오히려 큰 개인정보 침해 사고로 이어질 수 있습니다. 비식별정보도 안전하지 않을수 있다는것을 명심하고 기술적, 물리적, 관리적 보호조치를 함께 마련하고 적정성 검토를 통해 이용자의 환경에 대한 검토를 실시하여야 합니다.
최근에는 안면인식 훈련 데이터 셋에서 재식별이 되거나, COVID-19 감염자의 동선 데이터로 감염자의 신원을 재식별이 되었습니다. 공익 목적으로 공개된 데이터도 다른 정보와 결합하여 쉽게 개인을 식별할 수 있게 되면 공공의 목적보다는 개인정보 침해로 인한 피해가 더큰 문제가 됩니다. 가명정보는 처리자(취급자)가 가명처리가 잘 되었다는 판단을 직접 하면 절대 안됩니다. 적정성 검토를 거쳐 안전성을 확인하여야 하며, 이런 부분에 있어서 가명정보 전문 컨설팅 회사와 상의하는것을 권해드립니다.
이 글은 필자의 네이버 블로그에도 게시되었습니다.