가명정보와 추가정보의 분리 보관
개인정보를 가명정보로 만드는 과정에서 사용되는 매핑테이블, 알고리즘, 솔트와 같은 추가정보는 가명정보와 분리하여 보관하도록 하고 있습니다.
|
개인정보 보호법 시행령 제29조의5(가명정보에 대한 안전성 확보 조치) ① 개인정보처리자는 법 제28조의4제1항에 따라 가명정보 및 가명정보를 원래의 상태로 복원하기 위한 추가 정보에 대하여 다음 각 호의 안전성 확보 조치를 해야 한다. 제30조에 따른 안전성 확보 조치 가명정보와 추가정보의 분리 보관. 다만, 추가정보가 불필요한 경우에는 추가정보를 파기해야 한다. 가명정보와 추가정보에 대한 접근 권한의 분리. |
가명정보와 추가정보가 분리되어 보관되고, 접근권한을 분리하는것은 가명정보라는 것이 개인정보보호법 제2조(정의)에서 원래의 상태로 복원하기 위한 추가정보의 사용 결합 없이는 특정 개인을 알아볼 수 없는 정보를 가명정보로 정의하고 있기 때문입니다. 다시말해서 가명정보가 추가정보를 사용하면 특정 개인을 알아볼 수도 있기 때문입니다.
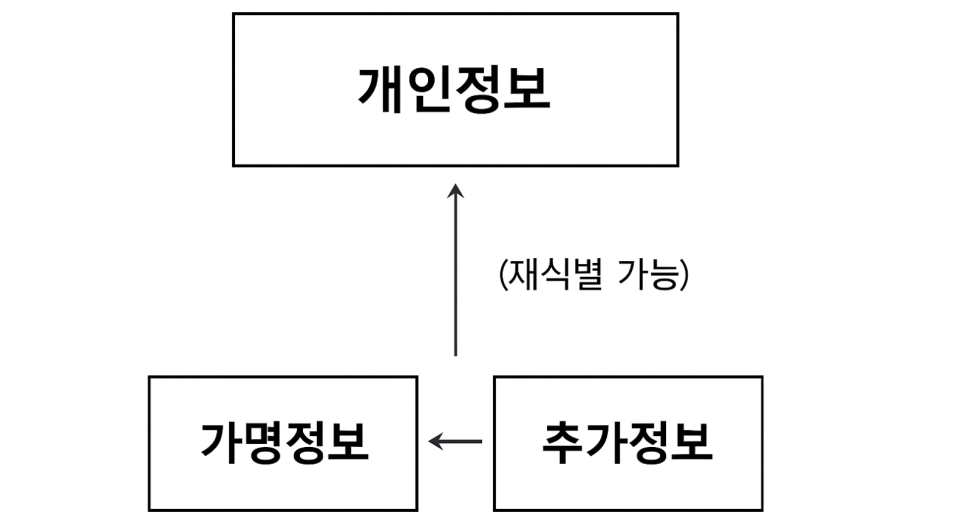
즉, 가명정보에 추가정보가 더해지면 재식별이 가능하게 되어 특정 개인을 알아볼 수 있는 정보가 될 수 있게 되며, 당초 개인정보를 수집할때 동의한 범위를 초과하여 사용하는 과정에서 재식별이 되어 개인정보 침해 문제가 발생하게 되므로 가명정보와 추가정보는 엄격히 분리되어 보관되도록 하고 있습니다.
그렇다면, 실제로 가명처리 과정에서 발생하는 추가정보에는 어떤 정보가 있을까요 ? 2020년 데이터 3법이 개정되면서 가명정보라는 개념이 도입되었고, 가명정보 특례에 의해 과학적 연구, 통계작성 목적으로 가명정보를 활용하는 많은 연구가 진행되었습니다. 가명정보는 익명정보와 달리 이용목적과 환경의 통제를 통해 연구목적을 달성할 수 있도록 하는 가명처리를 적용합니다. 이때 매핑테이블을 사용하여 가명처리하고, 이러한 매핑테이블을 추가정보로 분리보관하는 사례가 많이 있을까요? 그렇지 않습니다.
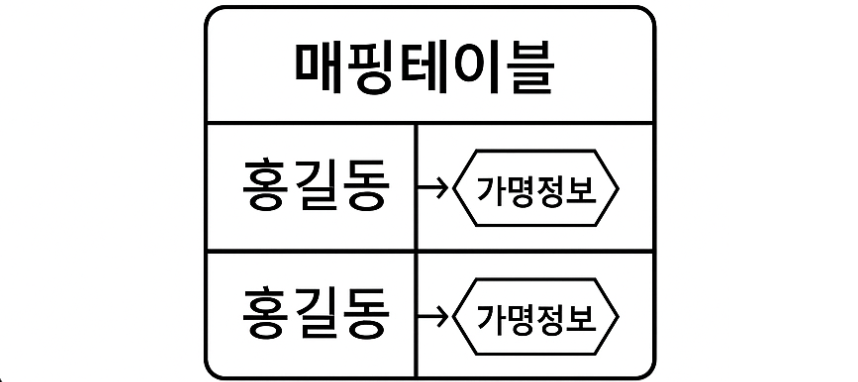
개인정보를 가명처리할때 데이터의 유형이 범주형 변수인지, 연속형 수치변수인지로 크게 구분하고 수치형 변수의 경우 상하단코딩을 적용하게 되므로 특별한 추가정보가 발생하지 않습니다. 범주형 변수의 경우 그 값의 의미를 모르게 바꾸기 위한 매핑테이블을 적용하는 경우보다는 변수의 빈도를 통해 재식별 가능성이 있는지를 판단하는 과정으로 가명처리를 수행하게 됩니다. 모든 경우가 그렇다는것은 아니지만 대부분이 그렇다는것이지요. 물론, 제가 경험한 사례중에는 매핑테이블을 적용하여 추가정보로 분리보관하는 사례도 한건 있기는 있었습니다. 그러나 대부분은 빈도를 분석하여 로컬삭제 또는 레코드삭제를 적용하는 처리를 적용한다고 말씀드립니다.
그럼, 추가정보는 언제 발생하게 될까요 ?
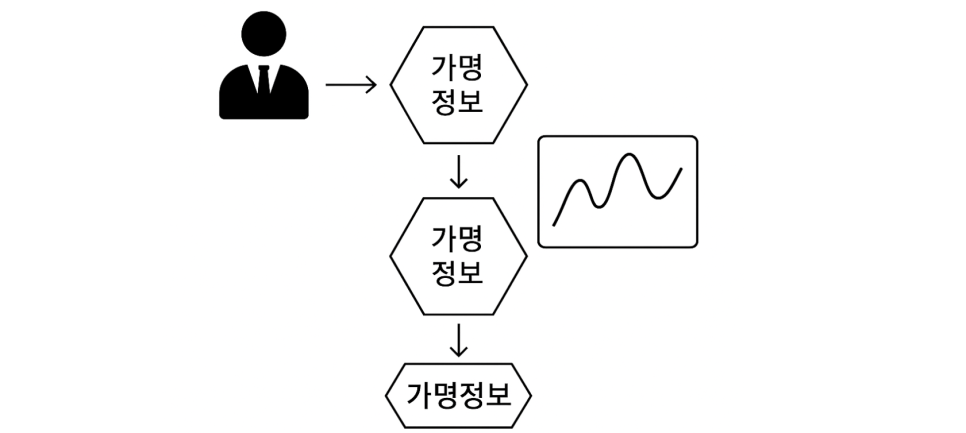
가명처리를 1회만 수행하는것이 아니라, 반복적으로 적용해야 한다고 할때 이전에 적용했던 알고리즘, 솔트값을 매 번 동일하게 적용하여야 반복적으로 생성되는 가명정보의 시계열 분석이 가능하게 됩니다. 이때 알고리즘, 솔트값은 추가정보에 해당이 되어 분리보관을 하여야 합니다.
그렇다면, 추가정보의 분리보관 방법은 어떻게 될까요 ?
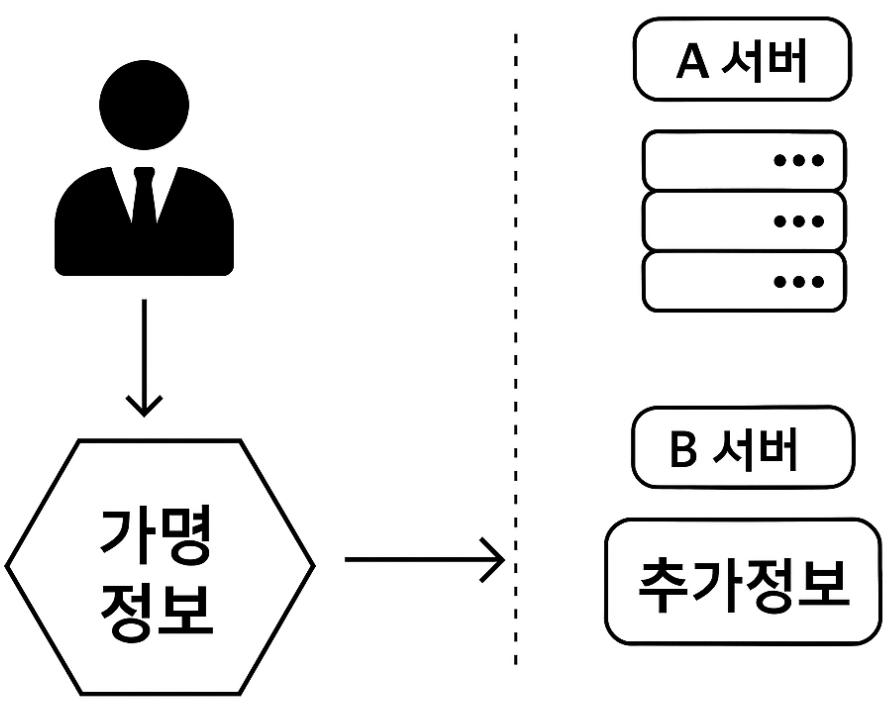
가장 좋은 것은 서버나 저장매체를 분리하여 저장하는 물리적 분리를 권장드립니다. 즉, 가명정보는 A서버에 두고, 추가정보는 B서버에 두는것입니다. 만일, 이렇게 물리적으로 분리보관하는 것이 어렵다면 논리적으로 분리하는것도 가능합니다. 동일한 A서버에 있지만 접근권한을 분리하고, 경로나 폴더를 다르게 분리하여 보관하는것입니다. 이때에는 이중 인증 등 접근에 대한 보호조치가 있어야 합니다. 추가정보에 대한 엄격한 접근권한을 분리하는것이 필요합니다.
추가로, 추가정보는 저장시 강력한 암호화(AES-256 등)을 적용하여 보관하고, 복호화키는 별도의 안전한 공간에 분리하는것이 좋습니다. 또한, 인터넷과 분리된 내부망에서만 접근 가능하도록 하는것도 권장합니다.
정기적으로 보관상태를 모니터링하고, 추가정보가 필요없게 되면 즉시 파기하여야 합니다.
이 글은 필자의 네이버 블로그에도 게시되었습니다.