데이터 전처리 - 실무 중심 전처리 방안
전처리란 무엇인가 ?
전처리(Preprocessing)는 데이터 분석 전에 데이터를 정제하고 가공하는 과정
잘못된 데이터, 결측치, 이상치 등을 처리해 데이터 품질을 높임
2. 왜 전처리가 중요한가 ?
전처리가 부족하면 분석 결과가 왜곡될 수 있습니다.
기계학습 모델의 성능을 저하시킬수 있습니다.
의사결정의 신뢰성이 하락될 수 있습니다.
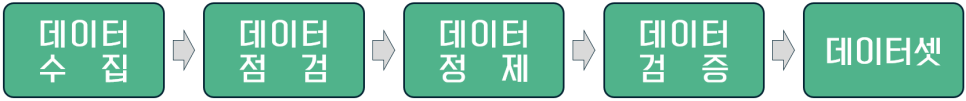
3. 데이터 전처리 단계별 방안
1) 데이터 점검
데이터 타입 확인 (수치형/문자형/날짜형)
결측치, 이상치 탐색
중복 데이터 확인
2) 결측치 처리
삭제 : 불필요한 행 제거
대체 : 평균값, 중앙값, 최빈값으로 채우기
예측 : 다른 변수로 결측치 예측
3) 이상치 처리
Box Plot 등 시각화로 탐색
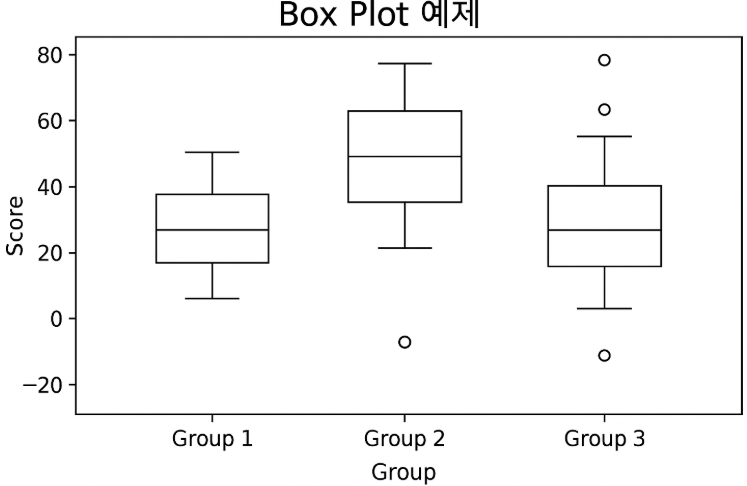
로그 변환, 극단값 제한
제거 혹은 수정
4) 데이터 변환
스케일링 (Data Scaling) - 특성 값의 범위를 일정한 범위로 맞추는 작업, Min-Max Scaling, Standard Scaling, Robust Scaling, MaxAbs Scaling
|
#Python Box Plot 예시 import matplotlib.pyplot as plt
# 그룹별 데이터 group1 = [70, 75, 80, 85, 90, 95, 100] group2 = [60, 65, 70, 75, 80, 100, 120] group3 = [50, 55, 60, 70, 80, 90, 110]
data = [group1, group2, group3]
plt.boxplot(data, labels=['Group1', 'Group2', 'Group3']) plt.title('Multiple Groups Box Plot') plt.ylabel('Score') plt.show() |
- 인코딩(Encoding) - Label Encoding, One-Hot Encoding, Ordinal Encoding, Binary Encoding, Target Encoding
- 파생 변수 생성 - 수학적 계산, 그룹통계, 날짜/시간 파생, 범주형 조합, 이진변수, 텍스트 길이, 단어수, 순위/랭킹
|
#Pyton 파생변수 예시 import pandas as pd
df = pd.DataFrame({ 'date': ['2025-07-10', '2025-07-11'], 'sales': [1000, 2000], 'quantity': [10, 20] })
# 날짜 파싱 df['year'] = pd.to_datetime(df['date']).dt.year df['month'] = pd.to_datetime(df['date']).dt.month
# 새로운 변수: 총매출 df['total'] = df['sales'] * df['quantity']
# 조건 파생 변수 df['high_sales'] = df['sales'].apply(lambda x: 1 if x > 1500 else 0)
print(df) |
이 글은 필자의 네이버 블로그에도 게시되었습니다.