가명처리에서 특이정보가 왜 중요한가?
우리가 흔히 아는 개인정보는 이름, 주민등록번호, 주소처럼 개인을 직접 식별할 수 있는 정보입니다.
그런데, 개인정보보호법에서는 개인을 직접 식별할 수 없더라도 다른정보와 쉽게 결합하여 개인을 알아볼 수 잇는 정보도 개인정보로 정의하고 있습니다. 이때 특정 개인을 알아볼 수 있게 만드는 정보들이 특이정보에 해당됩니다.
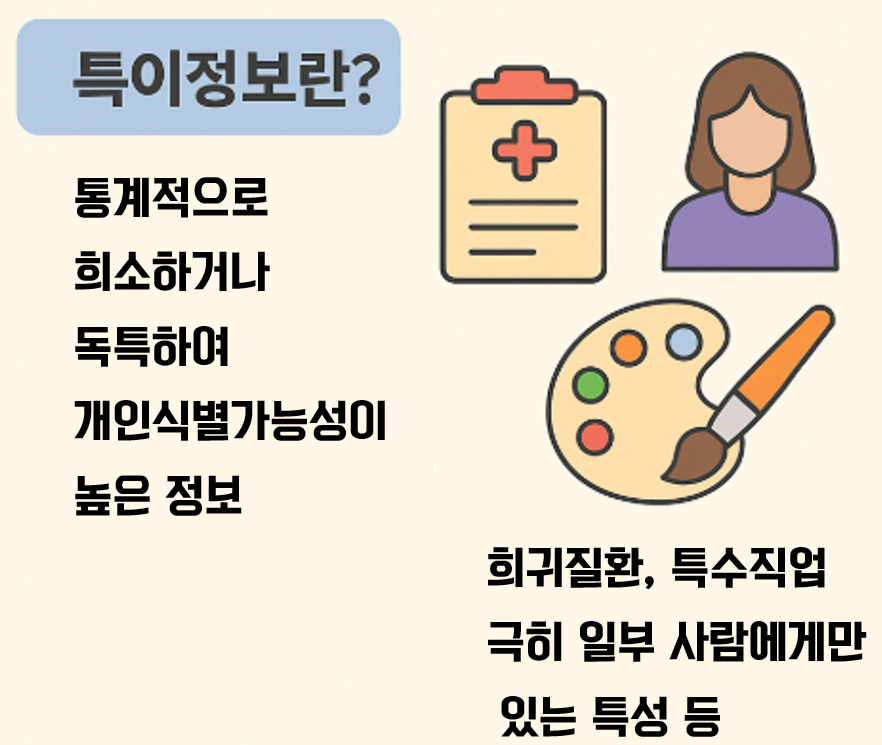
특이정보란
통계학적으로 희소하거나 독특하여 개인 식별 가능성이 높은 정보입니다. 예를들어서 희귀질환 질병, 특수 직업, 극히 일부 사람에게만 있는 특성 등이 해당됩니다.
왜 특이정보가 중요할까요 ?
특이정보는 일반정보처럼 보여도 다른 정보와 결합하게 되면 개인 식별위험이 매우 높아집니다. 예를들어서 한 지역에 단 한명뿐인 희귀병 환자의 진료기록은 이름이 없더라도 그 지역과 병명만으로도 누구인지 쉽게 특정할 수 있게 됩니다.
그런데, 이런 특이정보는 데이터를 분석할때 목적과 직접 관련이 없다면 데이터 분석에 오류를 더 발생시킬수도 있습니다.
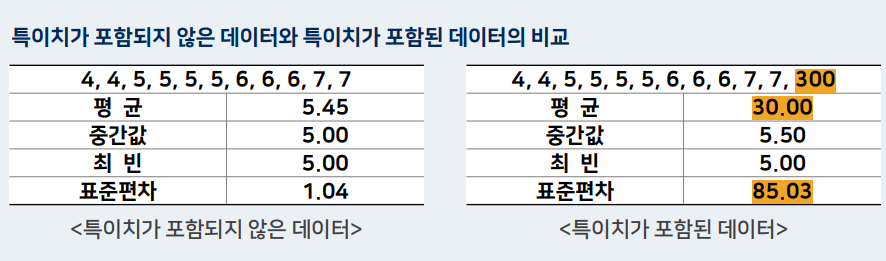
특이치가 포함되지 않은 왼쪽 데이터셋은 평균, 중간값, 최빈값을 보았을때 데이터 셋이 주로 평균값인 5.45근처에 값이 많이 있을것으로 판단하여 5, 6에 해당되는 값이 많을것으로 분석됩니다.
그런데, 이러한 데이터셋에 특이치 300이 하나 포함되면서 평균이 30으로 바뀌게 됩니다. 이 경우 평균값에 30근처에 값이 많을것이라는 예측은 완전히 빗나가게 됩니다. 또한, 300이라는 값은 다른값과 비교하여 너무 구분이 되므로 식별 가능성도 상당히 높습니다. 이러한 경우 식별가능성이 높은 특이치 값을 제거하고 데이터를 분석하는것이 데이터의 분석결과가 오히려 더 정확해지는것을 알 수 있습니다.
가명처리시 특이정보는 어떻게 다루어야 할까요 ?
개인정보보호법과 가명정보 처리 가이드라인에서는 가명정보를 안전하게 처리하기 위해 식별 위험성 평가를 반드시 하도록 하고 있습니다. 이때 특이정보가 포함되어 있으면 아래와 같은 보완조치를 권장합니다.
데이터 범주화 : 너무 세세한 특성을 일반화 하기
통계적 마스킹 : 소수집단 정보는 그룹화하거나 삭제
결합 제한 : 다른 추가정보와 결합시 개인 식별 가능성 재평가
별도 관리 : 특이정보는 별도 테이블로 분리 보관
가명정보 처리 가이드라인의 특이정보 예시
1) 국회의원 같이 특정 지역에서 소수만 존재하는 직업의 경우 지역구 국회의원 명단 등을 통해 개인이 식별될 수 있음.
2) 호텔, 렌터카 등 여행업종에서 보유중인 최고급 객실이용정보, 특정 차량이용정보는 개인(공인 등)이 SNS등 온라인에 공개하는 정보와 결합되어 개인이 식별될 수 있음.
3) 공인이 희귀질병을 앓고 있는 경우 해당 병명만으로 개인이 식별될 수 있음.
데이터 활용을 위해 가명처리를 하였다고 하더라도 특이정보가 포함되어 있다면 개인을 재식별할 가능성이 매우 높아집니다. 그래서 가명처리 단계에서는 특이정보의 탐지 및 처리가 필수입니다.
특이정보는 왜 주의가 필요한가요 ?
가명정보도 개인정보에 해당되므로 가명정보라도 개인이 특정될 수 있으면 개인정보 침해로 간주됩니다. 따라서, 데이터 결합 · 분석을 할 때 특이정보가 포함되어 있는지 점검하고, 전문가의 검토를 거쳐야 안전합니다.
특이정보, 사소해 보여도 결코 사소하지 않다.
데이터의 가치가 높아질수록, 그 안에 숨어 있는 특이정보도 함께 주목받습니다. 데이터를 안전하게 활용하기 위해서는 특이정보에 대한 이해와 관리가 필수라는점, 꼭 기억하시기 바랍니다.
이 글은 필자의 네이버 블로그에도 게시되었습니다.